Case Study
DocInspect
Prüfung von Gehaltsabrechnungen für Kreditanträge
Gefälschte Einkommensnachweise sind ein Klassiker im Kreditbetrug. DocInspect prüft eine Gehaltsabrechnung in Sekunden: Rechnet sie? Stimmen Sozialabgaben und Kennungen? Wurde das PDF nachträglich bearbeitet? Gibt es den Arbeitgeber? Jeder Befund ist nachrechenbar — und die KI entscheidet nie über Betrug.
Python · PyMuPDF · Codex CLI · Pydantic · Tesseract OCR · FastAPI
Repository privat — Einblick auf Anfrage
30/30
manipulierte Abrechnungen erkannt (synthetisches Eval)
0
fälschlich ROT auf Mustern echter Lohnprogramme
10/10
erfundene Arbeitgeber per Websuche markiert
77
automatisierte Tests
Das Problem
Zehn Jahre Kreditentscheidung haben mir gezeigt, wie Einkommensnachweise manipuliert werden: ein höheres Brutto, das nicht zu den Abzügen passt; eine SV-Nummer, die es nicht gibt; ein Arbeitgeber, den niemand kennt; ein Jahresbrutto, das nicht zum Monat passt; Zahlen in einer Schrift, die vom Rest des Dokuments abweicht.
Ein Sachbearbeiter erkennt das — wenn er Zeit hat, nachzurechnen. Ein LLM zu fragen „Ist das gefälscht?“ ist keine Lösung: Das Urteil ist nicht nachvollziehbar, und keine Bank darf eine Kreditentscheidung auf ein Bauchgefühl stützen.
Das Prinzip: Die KI liest, Regeln entscheiden
KI nur fürs Lesen
Das Modell überträgt Werte wörtlich in ein festes Schema. Es rechnet nicht, es bewertet nicht.
Jeder Wert belegt
Der Code prüft, ob jeder ausgelesene Betrag, jedes Datum, jede Kennung tatsächlich im Dokument steht.
Regeln entscheiden
Arithmetik, Sozialversicherung, Prüfziffern, Datums- und Jahreswerte, PDF-Forensik — jedes Urteil mit Soll und Ist.
Nie ROT auf Unsicherem
Beruht ein harter Befund auf einem nicht belegten Wert oder einem Scan, wird er GELB: Ein Lesefehler darf keinen Betrugsverdacht auslösen.
Der Ablauf
- 01PDF lesen — wie ein Mensch es sieht: weiß überdeckte Originalwerte fliegen raus, Scans gehen durch Tesseract-OCR
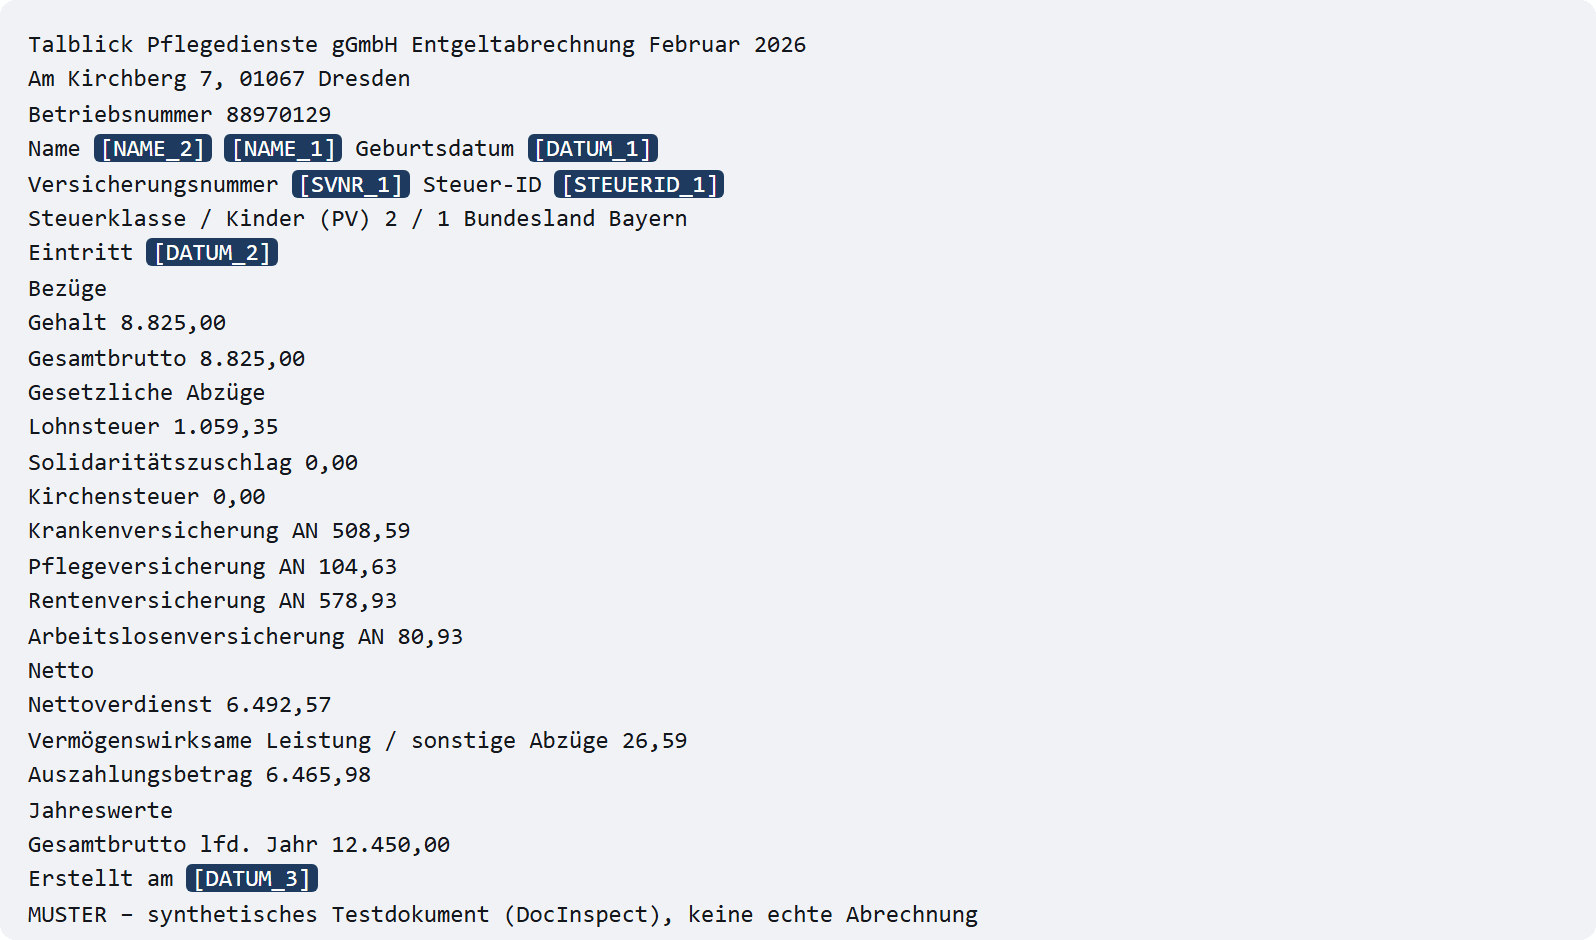
- 02Lokal pseudonymisieren: Name, SV-Nummer, Steuer-ID, Konto, Datumsangaben, Straße und Konfession werden zu Platzhaltern — fail-closed
- 03KI-Extraktion auf den Platzhaltern (isolierter Codex-Agent ohne Datei- und Werkzeugzugriff, festes JSON-Schema), danach exakte Rückübersetzung
- 04Belegprüfung: Jeder Wert muss im Dokument stehen — auch in DATEV-Schreibweisen wie „67940“ für 679,40
- 05Regelwerk, PDF-Forensik und Arbeitgeber-Recherche → Ampel mit Begründung
Deep Dives
1. Der überklebte Wert
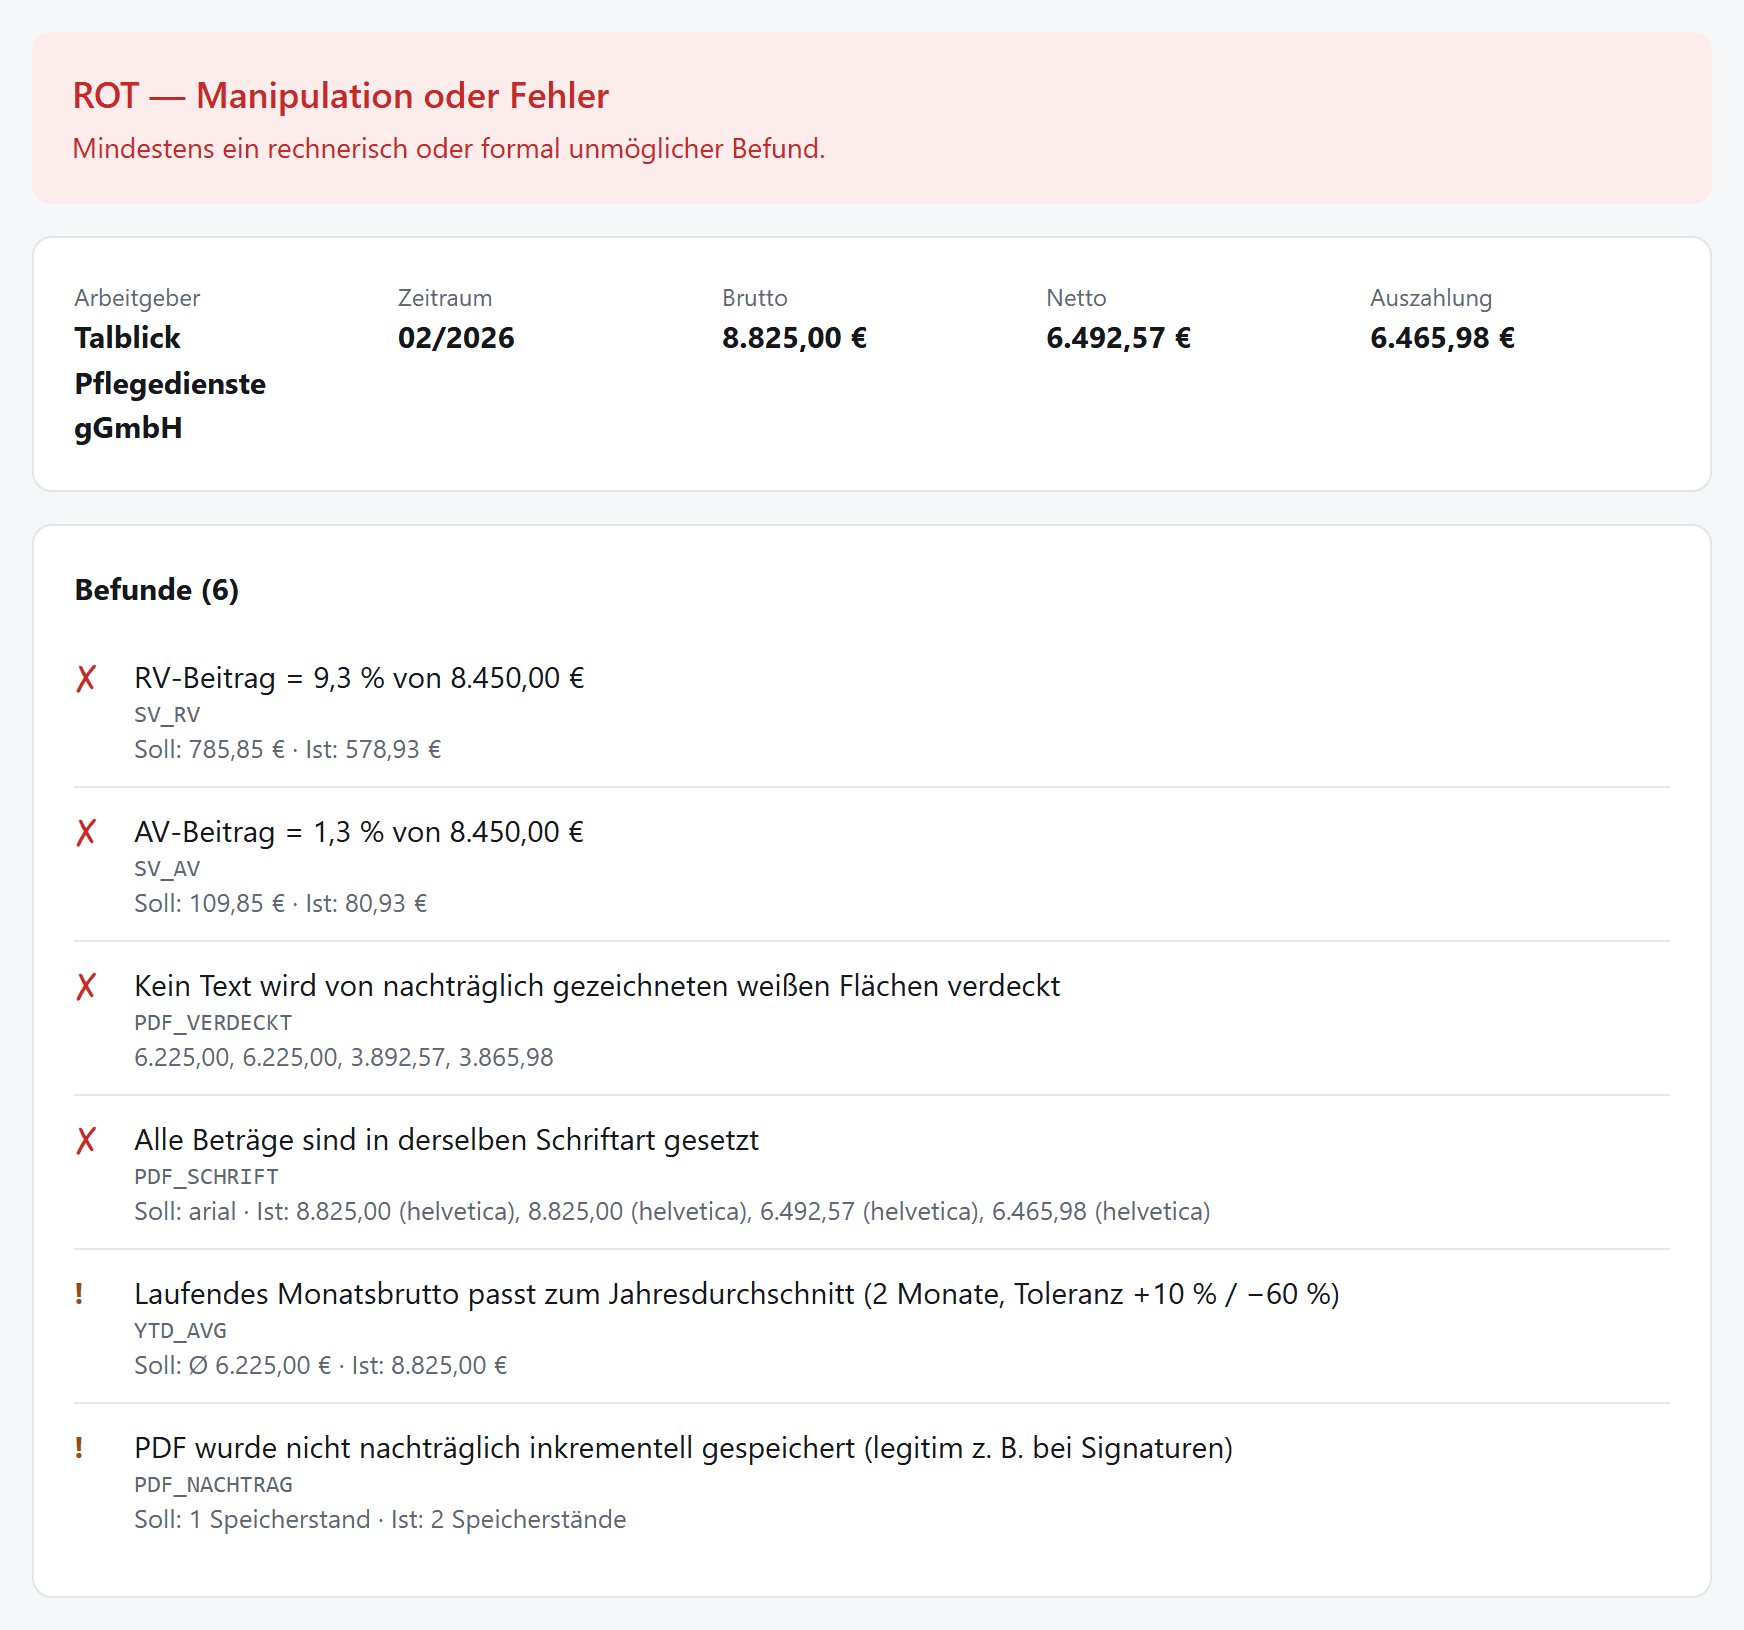
Der typische Fälscher-Workflow: alten Betrag mit einem weißen Kasten überdecken, neuen darüberschreiben. Optisch sauber — strukturell nicht. In der PDF-Zeichenfolge liegt der Originalwert weiter vor dem Kasten, und der neue Wert steht meist in einer anderen Schrift. DocInspect vergleicht die Zeichenreihenfolge von Text und Flächen und die Schriftfamilien aller Beträge. Nebeneffekt: Die KI bekommt nur den sichtbaren Text — anfangs hatte sie den verdeckten Originalwert ausgelesen.
2. Warum die KI nichts umrechnen darf
Erster Versuch: Beträge als Zahl im Format 1234.56 anfordern. Ergebnis: Aus „6.225,00“ wurde 6.15. Die Belegprüfung fing es sofort ab — der Wert stand nirgends im Dokument. Seitdem kopiert das Modell Werte nur wörtlich, umgerechnet wird im Code. Dasselbe Muster später bei Netto-Abzügen: Ein abstrakter „Saldo“ wurde als Auszahlungsbetrag missverstanden; einzelne Posten mit der Angabe Abzug oder Bezug funktionieren zuverlässig.
3. Der Realitätscheck kippte sieben Annahmen
Auf synthetischen Daten stand alles bei 100 %. Dann neun öffentliche Muster echter Lohnprogramme (DATEV, Lexware, Abacus, Power-Lohn): Sozialabgaben auf ein anderes SV-Brutto (Gehaltsumwandlung), DATEV-Beträge ohne Komma, freiwillig Versicherte mit netto verrechnetem KV-Beitrag, Jahreswerte nur als SV-Brutto, einzeln positionierte Wörter ohne Leerzeichen in der Textebene. Ohne Anpassung hätte es Fehlalarme gegeben. Danach: kein einziges fälschliches ROT durch Regeln oder Lesefehler — die zwei verbliebenen ROTs sind Test-Steuer-IDs in DATEV-Mustern, korrekt erkannt.
4. Der Platzhalter, der eine Steuer-ID erfand
Pseudonymisierung ersetzt personenbezogene Werte durch Platzhalter. Ein sprechender Platzhalter wie [STEUERID_1] auf einer harmlosen Zahlenreihe (Urlaubstage „30 270 270 540“) ließ das Modell eine Steuer-ID ausgeben, die es im Dokument gar nicht gab. Ganz neutrale Platzhalter wiederum verwirrten es bei DATEV-Tabellen, wo Beschriftung und Wert in verschiedenen Zeilen stehen. Die Lösung: Ein Platzhalter trägt nur dann eine Bedeutung, wenn das Format sie beweist — bei gültiger Prüfziffer. Und ein „PLZ + Ort“-Muster gibt es bewusst nicht: Es hätte DATEV-Beträge ohne Komma zerstört.
5. Gibt es den Arbeitgeber?
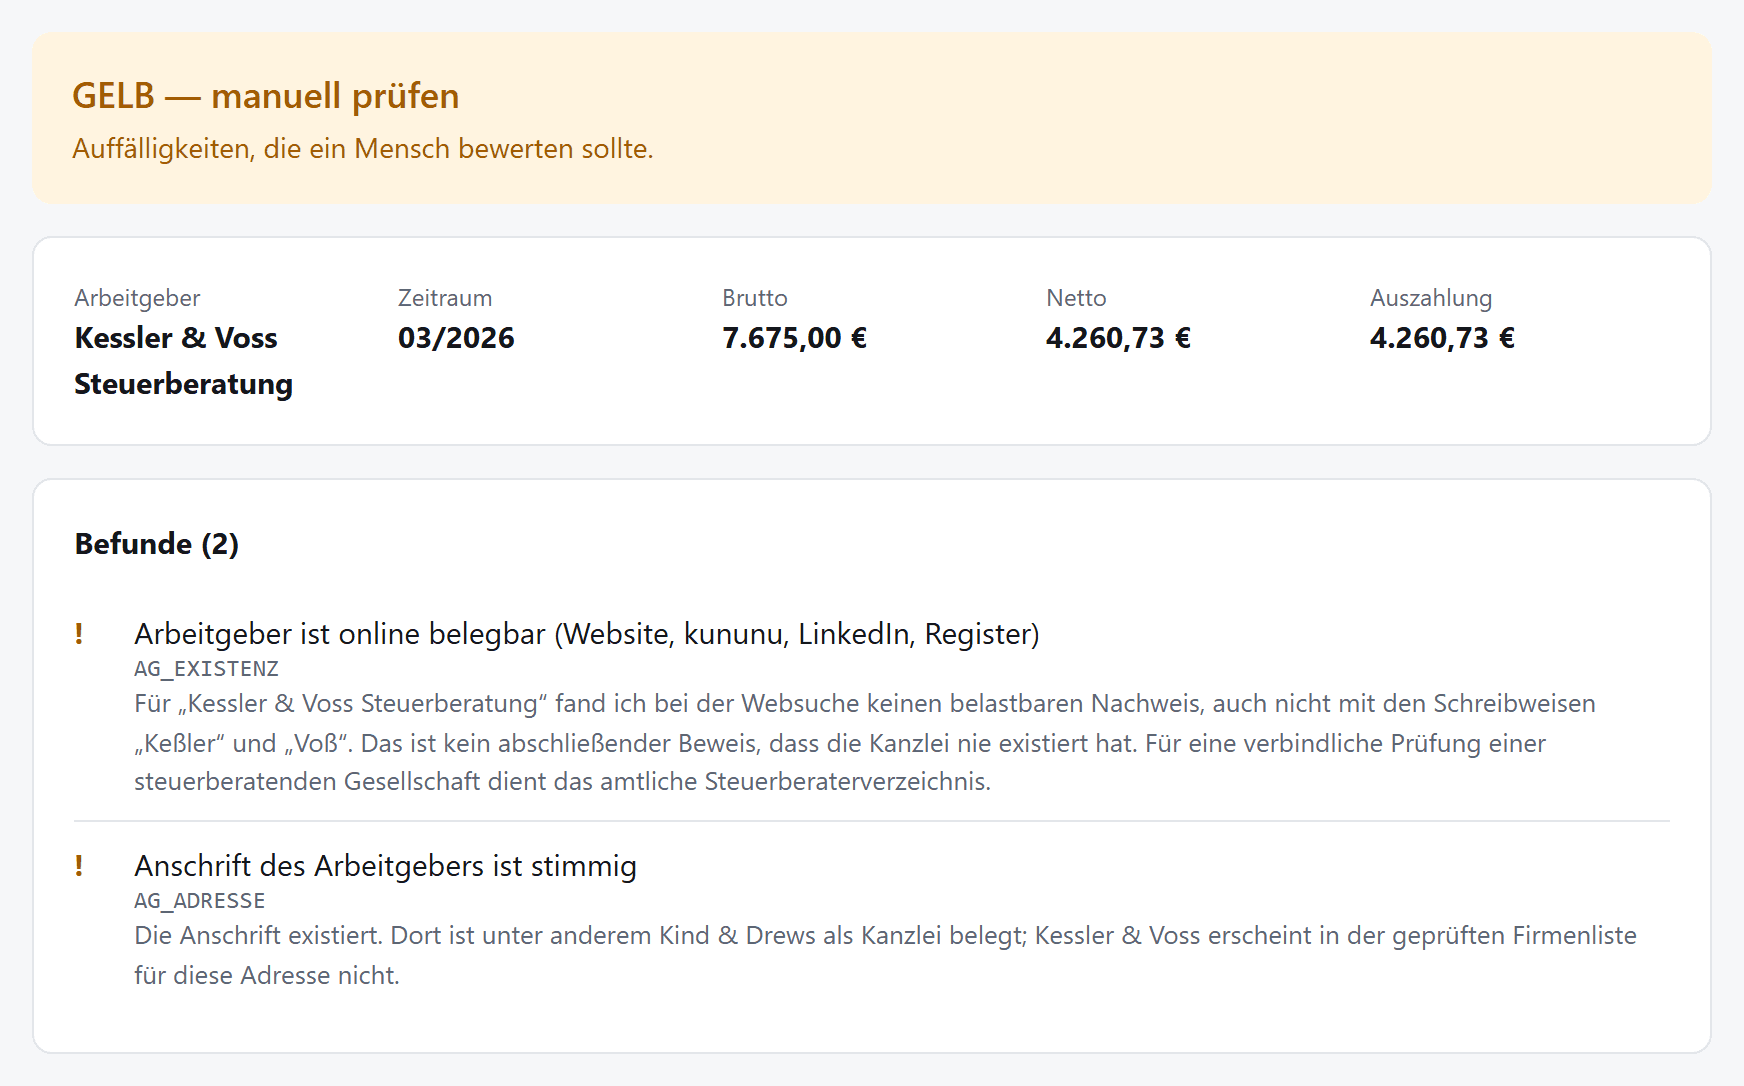
Die KI recherchiert per Websuche Firmenwebsite, kununu, LinkedIn und Handelsregister — der Code ruft danach jede genannte Quelle selbst ab und prüft, ob der Firmenname dort steht. Eine erfundene URL zählt nicht. Ergebnis: 8 von 8 echten Arbeitgebern belegt, 10 von 10 erfundenen markiert, meist mit präzisem Grund („Lindenallee 19 liegt in 50968 Köln, nicht 50667“). Ein zufällig realer Firmenname fiel über die falsche Adresse auf — genau das Muster „echte Firma, falsche Anschrift“.
6. Die eigene Datenschutz-Zusage auf den Prüfstand gestellt
„Vor jeder KI-Verarbeitung pseudonymisiert“ klang gut — eine gezielte Gegenprobe zeigte, dass es nicht stimmte. Der Codex-Agent erbte meine persönliche Konfiguration und las trotz Read-only-Sandbox eine Testdatei außerhalb seines Arbeitsordners; über eine präparierte Abrechnung (Prompt-Injection) wäre das ausnutzbar gewesen. Dazu: Namensteile unter drei Zeichen blieben im Klartext, „Stellplatz 40,00“ wurde als Straße ersetzt und der Betrag zerstört, und die Arbeitgeber-Recherche hätte bei Einzelunternehmen den Namen der Person an die Websuche geschickt. Jetzt läuft der Agent isoliert ohne Datei- und Werkzeugzugriff (ein Skript weist es mit einer Kennwort-Datei nach), jede Lücke hat einen Regressionstest — und die Zusage ist so formuliert, wie sie belegbar ist. Danach der Angriff von außen: Drei präparierte Abrechnungen mit sichtbaren und versteckten Anweisungen an die KI — keine wurde GRÜN, kein Dateiinhalt kam zurück.
Die Zahlen
Synthetisches Set
65 Abrechnungen, 7 Manipulationsarten, 3 Layouts
30/30 erkannt · 1/30 Fehlalarm (GELB) · 1820/1820 Felder korrekt
Echte Lohnprogramme
9 öffentliche Muster, 2005–2025, inkl. Scan
0 fälschlich ROT durch Regeln oder Lesefehler
Arbeitgeber-Recherche
8 reale, 10 erfundene Arbeitgeber
8/8 belegt · 10/10 markiert
Prompt-Injection
sichtbare und versteckte Anweisungen, Versuch, eine lokale Datei auszulesen
3/3 abgewehrt: nie GRÜN, kein Dateiinhalt ausgeleitet
Grenzen — bewusst benannt
- Eine gute Fälschung, die alle Werte konsistent neu berechnet, erkennt keine Plausibilitätsprüfung (0/5 im Eval). Dafür braucht es den Abgleich mit dem Gehaltseingang auf dem Kontoauszug.
- Die Lohnsteuer wird noch nicht nachgerechnet; geplant ist der offizielle BMF-Programmablaufplan.
- Scans werden per OCR gelesen, aber nie ROT — OCR-Fehler stehen auch im Belegtext und lassen sich dort nicht erkennen.
- Prototyp mit Codex CLI über ein ChatGPT-Abo (~10 s pro Extraktion); im Betrieb ein direkter API-Aufruf oder ein lokales Modell.