Case Study:
Papierkram-Orakel
Lokales RAG-System für den privaten Papierkram
Bedienungsanleitungen, Verträge, Garantien, Rezepte: der Ordner, den niemand liest — verwandelt in eine Wissensbasis, die Fragen in Alltagssprache beantwortet und jede Aussage mit Datei und Seite belegt.
100 %
Suche & Ranking lokal
20/20
Eval-Fragen korrekt
7
Dateiformate inkl. Scans & Fotos
1
Cloud-Schritt — austauschbar
Motivation
Warum dieses Projekt?
Jeder Haushalt besitzt einen Ordner (oder zwanzig), dessen Inhalt praktisch nie gelesen wird — bis die Waschmaschine blinkt oder eine Kündigungsfrist droht. Klassische Volltextsuche scheitert, weil man die Wortwahl des Dokuments nicht kennt; ein LLM einfach fragen scheitert, weil es den Mietvertrag nicht kennt und im Zweifel halluziniert. RAG (Retrieval Augmented Generation) löst genau dieses Problem: Erst finden, dann formulieren. Bewusst lokal gebaut — private Verträge und Belege gehören nicht als Suchindex in eine Cloud, und eine SQLite-Datei pro Wissensgebiet bedeutet: kein Vendor-Lock-in, jederzeit exportierbar, löschbar, versionierbar.
Wofür es im Alltag taugt
Architektur
Die Architektur
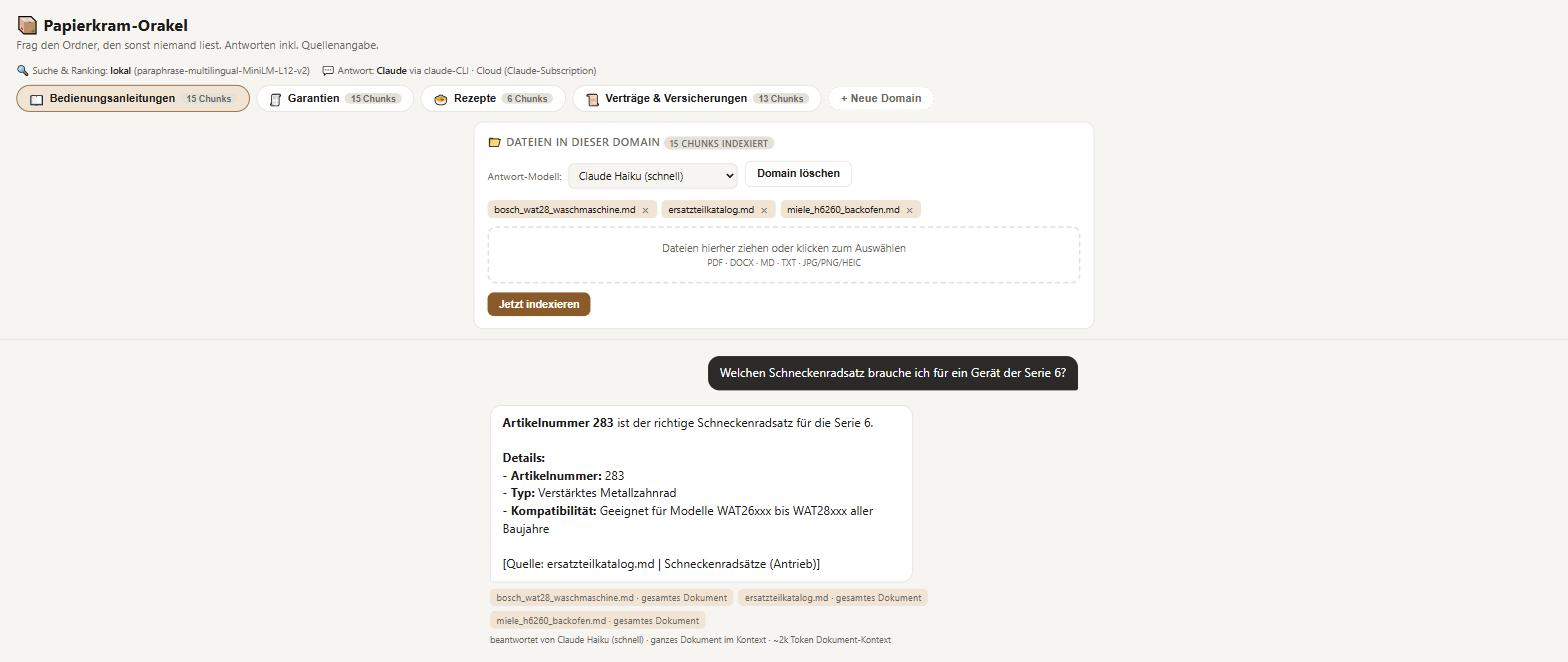
Zwei Phasen: Bei der Indexierung werden Dokumente geparst (inkl. OCR für Scans und Handyfotos), absatzweise in ~700-Zeichen-Chunks geschnitten, lokal embedded und in einer SQLite-Datei mit Vektor- und Volltextindex abgelegt. Bei jeder Frage prüft das System zuerst, ob das ganze Wissensgebiet ins Kontextfenster passt — dann geht es komplett ans LLM. Nur bei größeren Beständen laufen Vektor-Suche und BM25 parallel, werden per Reciprocal Rank Fusion verschmolzen, ein Cross-Encoder sortiert die Kandidaten fein. In beiden Fällen formuliert das LLM strikt begrenzt auf die übergebenen Textstellen.

Die Anwendung
Deep Dives
Deep Dives & Herausforderungen
1. Hybrid Search mit Reciprocal Rank Fusion
Semantische Suche findet »Feinwäsche-Programm«, wenn man nach »Wolle waschen« fragt — aber sie verwechselt Ersatzteil 4055-C mit 4055-D, weil beide fast identisch klingen. Deshalb laufen Vektor-KNN (sqlite-vec) und BM25-Volltextsuche (FTS5) parallel; die Fusion arbeitet rein rangbasiert (Score = Σ 1/(60+Rang)), wodurch Cosine-Distanz und BM25-Score vergleichbar werden, ohne Normalisierungs-Tricks. Ein Chunk, der in beiden Listen vorn liegt, gewinnt. Deutsche Frage-Füllwörter (»wie«, »viele«, »pro«) fliegen vorher aus der Volltext-Query, damit sie den seltenen Fachbegriff nicht verwässern.
2. Ein Failure Mode — und die Konsequenz für die Architektur
Das LLM bekommt ausschließlich die gefundenen Textstellen plus die Anweisung, jede Aussage mit [Quelle: Datei | Ort] zu belegen und Nichtwissen zuzugeben. Ein Praxistest deckte die Kehrseite auf: Bei einer 20-seitigen Baubeschreibung antwortete das System auf »wie viele Steckdosen pro Etage« mit »steht nicht in den Unterlagen« — obwohl die raumweise Elektroliste auf Seite 15–17 stand. Die Diagnose zog sich durch alle drei Retrieval-Stufen: Der Bi-Encoder bildet knappe Stichpunktlisten weit weg von Prosa-Fragen ab, der Reranker schob die BM25-Treffer sogar aktiv nach hinten, und vier Chunks fassen keine vier Seiten Raumlisten. Konsequenz: Passt ein Wissensgebiet ins Kontextfenster, wird gar nicht mehr gesucht — das ganze Dokument geht ans LLM.
3. Ganze Domain statt Suche — und die Kosten sichtbar
Retrieval mit vier Chunks war eine Antwort auf kleine Kontextfenster von 2023. Eine private Dokumentensammlung — ein Lebenslauf, alle Handbücher, ein Ordner Bauunterlagen — ist 10–60k Token und passt komplett in Claudes 200k. Also entscheidet ein Zeichen-Budget pro Wissensgebiet: passt alles rein, geht alles ans LLM; erst darüber schaltet die Hybrid-Suche zu. Unter jeder Antwort steht, wie groß der Dokument-Kontext war und ob der 1-Stunden-Prompt-Cache der Claude-CLI griff — Folgefragen ans selbe Gebiet kosten dann rund ein Zehntel.
4. OCR-Fallback für die analoge Realität
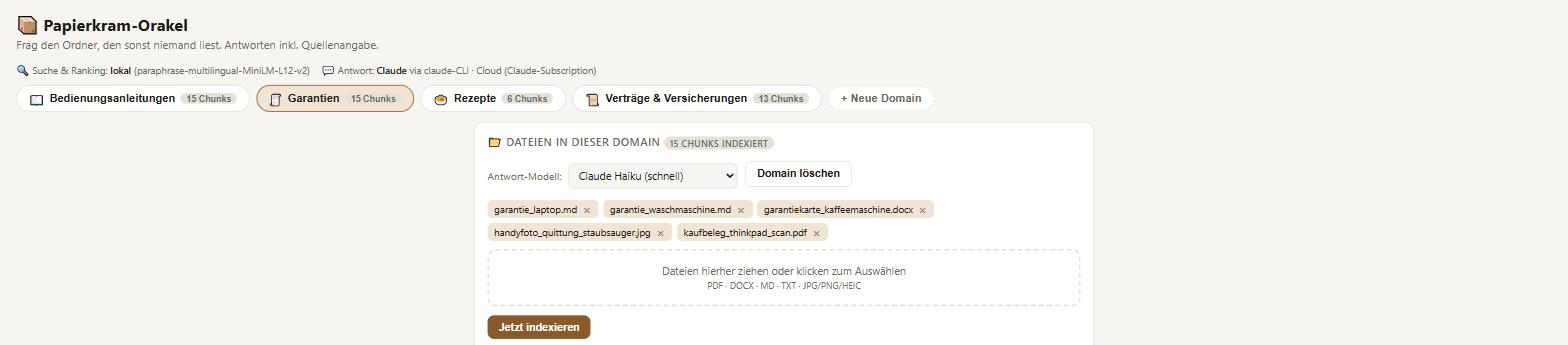
Der Papierkram-Ordner enthält nicht nur digitale PDFs, sondern gescannte Kaufbelege und Handyfotos von Quittungen. Die Parser-Registry erkennt Seiten ohne Textebene und schickt sie automatisch durch Tesseract-OCR — im Praxistest wurde ein gescannter Behörden-Schriftwechsel korrekt indexiert und zitierfähig, inklusive Kennzeichnung »(OCR)« in der Quellenangabe.
5. Reranking mit Kandidaten-Pool — und wann man es weglässt
Der Cross-Encoder liest Frage und Chunk gemeinsam und bewertet Relevanz deutlich genauer als der Vergleich zweier vorab berechneter Vektoren. Für den Hybrid-Pfad holt die Suche einen vergrößerten Kandidaten-Pool (Vektor-Top-15 + BM25-Top-15), aus dem nach dem Reranking die besten zwölf ans LLM gehen. Aus dem Praxistest gelernt: Bei »wie viele …«-Fragen schadet das Reranking, weil es auf den einen bestpassenden Chunk fokussiert und die Geschwister verdrängt — ein weiterer Grund, warum der Ganzes-Dokument-Pfad der Standard ist, wo immer er passt.
6. Qualität messbar machen statt durchklicken
Ein Eval-Testset mit 20 handgeschriebenen Fragen prüft Retrieval-Trefferquote und Antwort-Korrektheit gegen erwartete Quellen und Stichworte — inklusive bewusst harter Fälle wie fast identischer Artikelnummern und einem synthetisch gescannten PDF ohne Textebene. Dazu 36 Offline-Unit-Tests (ohne Modelle, ohne CLI), die in der CI auf Python 3.11–3.13 laufen. Aktueller Stand: 20/20 Retrieval-Treffer, 20/20 korrekte Antworten.
Austauschbares LLM-Backend
Das LLM ist der kleinste Baustein — und in Minuten ersetzt
Die gesamte Intelligenz der Suche — Embeddings, Hybrid-Retrieval, Reranking — läuft lokal und modellunabhängig. Das Sprachmodell kommt erst im allerletzten Schritt ins Spiel und ist hinter einer einzigen Funktion gekapselt: generate_answer(domain, frage, fundstellen). Wer volle Offline-Fähigkeit will, tauscht diese eine Funktion gegen einen Ollama-Call — der Rest des Systems merkt davon nichts.
Claude CLI (aktuell)
Headless über die bestehende Subscription, Modell pro Wissensgebiet in der Web-UI umschaltbar (haiku/sonnet/opus).
Ollama — komplett lokal
Ein HTTP-Call an localhost statt Subprocess: qwen2.5 oder llama3.1 machen das System nach dem Erstsetup vollständig offline-fähig.
Beliebige API
Anthropic-, OpenAI- oder ein anderer API-Call — Prompt-Aufbau und Zitatpflicht bleiben identisch.
Suche und Ranking bleiben in jedem Fall lokal — getauscht wird nur, wer den letzten Satz formuliert.
Unter der Haube
Engineering Details
Eine SQLite-Datei pro Wissensgebiet
Drei Tabellen mit geteilter Row-ID: Klartext + Metadaten, FTS5-Volltextindex, sqlite-vec-Vektorindex (384 Dim.). Export, Backup oder Löschen = eine Datei kopieren oder entfernen.
Absatzbewusstes Chunking
~700 Zeichen mit 10 % Overlap, geschnitten an Absatzgrenzen statt mitten im Satz; überlange Absätze fallen auf ein Sliding Window zurück. Jeder Chunk behält Datei und Fundstelle für das spätere Zitat.
Lokale Modelle, lazy geladen
Multilingualer MiniLM-Bi-Encoder für Embeddings, mmarco-Cross-Encoder fürs Reranking — beide CPU-tauglich und erst beim ersten Zugriff geladen, damit die CLI ohne Modell-Load startet.
Parser-Registry
Dateiendung → Parser-Funktion: PDF (digital + Scan), DOCX inkl. Tabellen, Markdown, TXT, JPG/PNG/HEIC. Neue Formate sind eine Funktion im Dict, kein Umbau.
Abgesicherter LLM-Aufruf
Headless-Call mit deaktivierten Tools, ohne Session-Persistenz, mit Timeout. Der Prompt geht über stdin (der Ganzes-Dokument-Modus sprengt sonst das Windows-Kommandozeilenlimit von ~32k); --output-format json liefert die Token-Zahlen zurück. Leere Trefferliste = statische Antwort ganz ohne LLM-Call.
Web-UI für Nicht-Techniker
FastAPI + Chat-Oberfläche: Wissensgebiet anlegen, Dateien per Drag & Drop, indexieren, fragen — dazu Domains und einzelne Dateien wieder löschen, das Antwort-Modell pro Gebiet umstellen, Token-Verbrauch und Lokal-vs-Cloud-Status ablesen. Kompletter Workflow ohne Terminal.
Ergebnis
Ergebnis
Das System beantwortet im Eval 20 von 20 Testfragen korrekt und mit richtiger Quelle — darunter die klassische RAG-Falle fast identischer Artikelnummern und ein nur per OCR lesbares Scan-PDF; abgesichert durch 36 Offline-Unit-Tests. Im Praxistest mit echten Hausbau-Dokumenten lieferte es seitengenaue Antworten aus einer 20-seitigen Baubeschreibung und kombinierte Behördenschreiben und Leitfaden zu einer sauber zitierten Antwort. Ein dabei aufgedeckter Retrieval-Fehler führte zur wichtigsten Architektur-Entscheidung: Passt ein Wissensgebiet ins Kontextfenster, sieht das Modell es ganz — kein Raten, keine Lücken.
Tech Stack